















ABIDJANMAG · CULTURE · TECHNOLOGIE
Le détecteur d’IA s’est-il trompé ?
Quand une machine accuse un écrivain, l’affaire Thélyson Orélien ouvre un débat vertigineux sur la fiabilité des détecteurs d’intelligence artificielle.
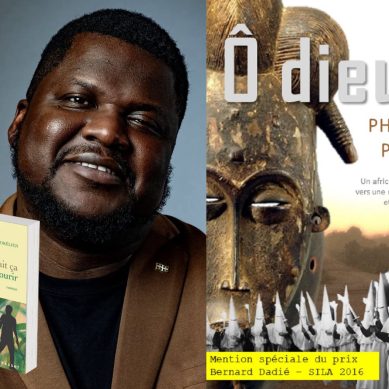
Un pourcentage affiché par une intelligence artificielle peut-il suffire à mettre en doute l’authenticité d’un écrivain ? La polémique autour de C’était ça ou mourir, de Thélyson Orélien, pose cette question avec une acuité nouvelle. L’expérience rapportée par l’écrivain ivoirien Philippe A. Pango sur son propre roman O dieux ajoute une seconde interrogation : que vaut réellement un score de détection lorsqu’il est confronté à l’histoire d’un manuscrit ?
L’essentiel
Un roman récompensé. Une accusation anonyme. Un détecteur d’IA. Et un chiffre supérieur à 95 % qui transforme une analyse statistique en affaire littéraire.
Une polémique au sommet de la rentrée littéraire
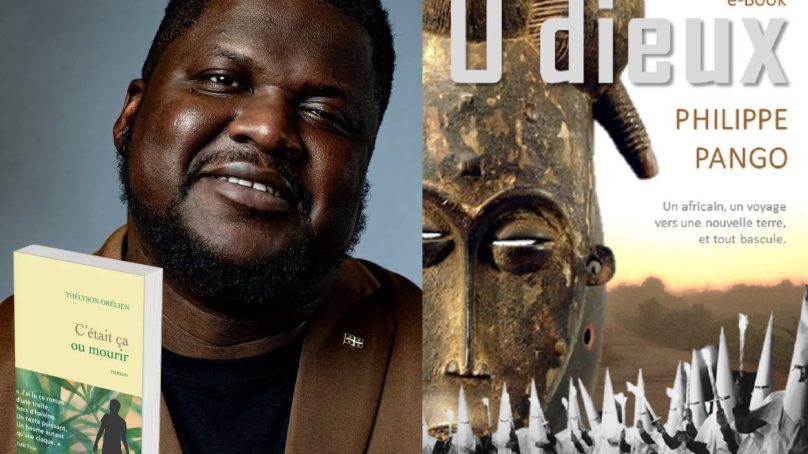
Publié au Québec par les Éditions du Boréal puis en France chez Grasset, C’était ça ou mourir raconte l’exil de Jonas Dorléon, professeur d’histoire-géographie contraint de fuir Haïti.
Le roman a connu une ascension spectaculaire. Il figure dans la première sélection du Prix Goncourt 2026 et a remporté le Prix du roman Fnac 2026, décerné par un jury réunissant 400 libraires Fnac et 400 adhérents.
La controverse éclate ensuite sur les réseaux sociaux. Un compte anonyme, « Balance ton Claude », accuse l’écrivain d’avoir utilisé massivement l’intelligence artificielle et s’appuie notamment sur des analyses de Pangram.
Le Monde a lui-même soumis plus de la moitié du roman à Pangram. Le résultat rapporté par le quotidien dépasse 95 % de texte considéré comme généré par IA, avec un niveau de confiance jugé élevé par l’outil.
>95 %
Part du texte analysé que Pangram a classée comme générée par IA dans le test rapporté par Le Monde.
Un détecteur n’est pas un témoin
Pangram n’observe pas un écrivain pendant qu’il travaille. Il ne voit ni son clavier, ni ses carnets, ni ses brouillons. Il analyse le texte qui lui est soumis et recherche des caractéristiques statistiques associées à des productions humaines ou générées par des modèles d’IA.
Pangram affirme avoir fortement réduit son taux de faux positifs. Dans son évaluation de Pangram 4, l’entreprise annonce un taux de 0,0041 % sur deux millions de documents humains antérieurs à 2022, soit environ un cas pour 24 000 documents dans ce jeu de test.
Mais ce chiffre est une mesure de performance sur un échantillon contrôlé. Il ne transforme pas automatiquement chaque résultat individuel en preuve de l’origine d’un manuscrit.
« Un détecteur d’IA n’est pas un détecteur de mensonge. »
Principe central de l’affaire
Le chiffre ne raconte pas toute l’histoire
C’est la distinction fondamentale.
Ce que dit le détecteur
Le texte présente des caractéristiques statistiques associées à une production générée par une IA.
Ce que cela ne prouve pas
Qui a écrit le texte, à quel moment, avec quels outils et selon quel processus de création.
Autrement dit, « ce texte ressemble statistiquement à un texte généré par IA » n’est pas exactement la même affirmation que « une IA a écrit ce texte ».
La différence est considérable lorsqu’il s’agit d’accuser publiquement un auteur.
L’expérience Philippe Pango
L’écrivain ivoirien Philippe A. Pango rapporte avoir voulu tester le problème sur un texte dont il connaît parfaitement l’origine : un extrait de son roman O dieux, publié en 2014.
Selon son propre récit, l’extrait soumis à Pangram a été classé à 66 % comme généré par IA et à 34 % comme humain.
Or, affirme l’auteur, il s’agit d’un texte dont il est lui-même l’auteur et dont il conserve des versions antérieures ainsi que des corrections manuscrites.
66 %
Résultat rapporté par Philippe A. Pango lors du test d’un extrait de son propre roman O dieux.
Important : ce résultat est celui rapporté par Philippe A. Pango dans son propre test. AbidjanMag ne l’a pas reproduit de manière indépendante et ne présente donc pas cette expérience comme une démonstration définitive d’une erreur de Pangram.
Le véritable enjeu : ressemblance ou origine ?
Les détecteurs recherchent des régularités dans la langue : structures syntaxiques, choix lexicaux, prévisibilité, répétitions et autres caractéristiques statistiques.
Mais les écrivains humains ont eux aussi des habitudes. Certains privilégient les phrases courtes, d’autres les constructions régulières, un vocabulaire particulier ou une prose très structurée.
Une machine peut donc identifier une ressemblance statistique sans nécessairement disposer de la preuve historique de l’origine du texte.
C’est précisément pourquoi l’analyse d’un manuscrit devrait idéalement être confrontée à d’autres éléments.
Le manuscrit comme pièce à conviction
Lorsqu’une question porte sur l’origine d’un texte, son histoire peut être aussi importante que son apparence finale.
- Brouillons et premières versions
- Corrections successives
- Notes et carnets de travail
- Versions numériques et métadonnées disponibles
- Échanges avec éditeurs, correcteurs ou premiers lecteurs
- Comparaison chronologique des différentes versions
Un détecteur peut constituer un élément d’alerte. L’historique documenté d’un manuscrit peut, lui, contribuer à reconstituer son processus de création.
La question décisive
Que veut-on établir : que le texte ressemble à une production d’IA, ou qu’une IA a effectivement participé à sa production ?
Dans l’affaire Orélien, que sait-on réellement ?
Le résultat de Pangram constitue un élément concret de la controverse. Mais il ne suffit pas, à lui seul, à reconstituer le processus d’écriture du roman.
Les accusations diffusées en ligne ont été contestées et les éditeurs de Thélyson Orélien ont maintenu leur confiance envers l’auteur. De son côté, le test réalisé par Le Monde apporte une donnée supplémentaire, mais ne transforme pas le détecteur en témoin direct de la création du livre.
La prudence est d’autant plus importante que Pangram lui-même présente son système comme un outil d’analyse probabiliste et reconnaît que ses performances dépendent notamment de la longueur, du type de texte et du domaine analysé.
Quand la capture d’écran devient un verdict
C’est peut-être le phénomène le plus préoccupant de cette nouvelle époque.
Une capture d’écran montrant un logo et un chiffre rouge — 95 % IA — est immédiatement compréhensible et facilement partageable.
Une véritable analyse demande au contraire des questions beaucoup moins spectaculaires :
À vérifier
Quelle version du texte ? Quelle longueur ? Quels passages ? Quelle version du détecteur ? Le résultat est-il reproductible ?
À confronter
Existe-t-il des brouillons, des versions antérieures, des métadonnées ou d’autres éléments indépendants permettant de retracer la création ?
Une expérience qui mérite d’être reproduite
Le cas rapporté par Philippe Pango ouvre une piste intéressante pour la recherche.
Plutôt que de multiplier les captures d’écran, pourquoi ne pas tester plusieurs détecteurs sur une véritable base de contrôle composée de romans publiés avant l’ère de l’IA générative, dont l’auteur et la chronologie sont établis ?
On pourrait ensuite comparer ces résultats avec des textes contemporains écrits sans IA, avec assistance IA et entièrement générés par IA.
Une telle approche permettrait de mesurer non seulement si les machines se trompent, mais surtout dans quelles conditions elles se trompent.
« Entre “ce texte ressemble à ce que produit une IA” et “cette IA a produit ce texte”, il existe une différence considérable. »
La prochaine bataille : prouver l’auteur
L’affaire dépasse largement le seul cas de Thélyson Orélien.
À mesure que les outils génératifs deviennent capables de produire des textes convaincants, une nouvelle question apparaît pour les écrivains, les éditeurs, les universitaires et les journalistes : comment démontrer l’histoire d’un texte ?
Conserver ses brouillons, archiver ses différentes versions, sauvegarder ses notes et documenter les étapes éditoriales pourraient demain devenir des réflexes aussi importants que l’écriture elle-même.
L’ironie est saisissante : l’IA ne pose pas seulement la question de savoir si une machine peut écrire. Elle oblige aussi les humains à réfléchir à la manière de prouver qu’ils ont écrit eux-mêmes.
Entre l’alerte et le verdict
Les détecteurs d’IA peuvent être utiles comme instruments d’analyse. Ils ne reconstituent cependant pas, à eux seuls, l’histoire d’un manuscrit.
Dans une affaire aussi sensible, le résultat statistique gagne à être confronté au contexte, aux versions antérieures du texte et aux éléments documentaires disponibles.
La bonne question n’est donc pas seulement : « Quel est le score ? » mais : « Quelles preuves permettent d’expliquer ce score ? »
Le mot de la fin
L’affaire C’était ça ou mourir pourrait finalement laisser une question plus importante que celle de savoir ce qu’a réellement fait ou non tel ou tel écrivain.
Si l’intelligence artificielle doit demain participer à l’évaluation de l’authenticité littéraire, ses propres résultats devront être examinés avec la même exigence que celle appliquée aux auteurs.
Un pourcentage peut déclencher une enquête. Il ne devrait pas, à lui seul, la remplacer.
À propos de Philippe A. Pango
Philippe A. Pango est écrivain. Il rapporte avoir soumis à Pangram un extrait de son roman O dieux, publié en 2014, et obtenu un résultat de 66 % classé comme généré par IA.
Cette expérience est présentée ici comme un témoignage et une piste de réflexion sur les limites possibles des outils de détection. Elle n’a pas été reproduite indépendamment par AbidjanMag.
« Cette tournure des événements venait fausser la compréhension que Carter avait de l’Africain moyen, ce nègre qui, normalement, se laisse si facilement conquérir. Les Blancs, peuple élu de Dieu, sont sous la loi de l’alliance de Dieu. Les autres peuples de la terre sont sous la loi de la nature que Dieu a créée. Cet enseignement, ce principe fondamental du Ku Klux Klan, maintes fois répété aux enfants de Vidor, semblait n’avoir pas marché cette fois-ci. […] »
Note de la rédaction : l’extrait est reproduit dans le cadre du débat rapporté par Philippe A. Pango. Le résultat de détection mentionné correspond à son propre test et ne constitue pas une expertise indépendante réalisée par AbidjanMag.


